



以太大模型烧烤摊"上岗"1小时:商业化场景等来第一个能用的具身大模型
作者:亿邦动力 文章来源:亿邦动力
2026-09-19 09:05

9月16日,上海街头的一场机器人户外直播,给具身圈子来了个“认知轰炸”:机器人不再是“自主智能”概念,而是真的敢在开放的现实场景里,展现服务能力了。
两台搭载乐享科技以太大模型在真实户外环境中连续工作了1小时,没有遥操作,没有预设脚本,机器人完全自主完成了从点单、任务规划、烧烤到上菜的完整服务流程。
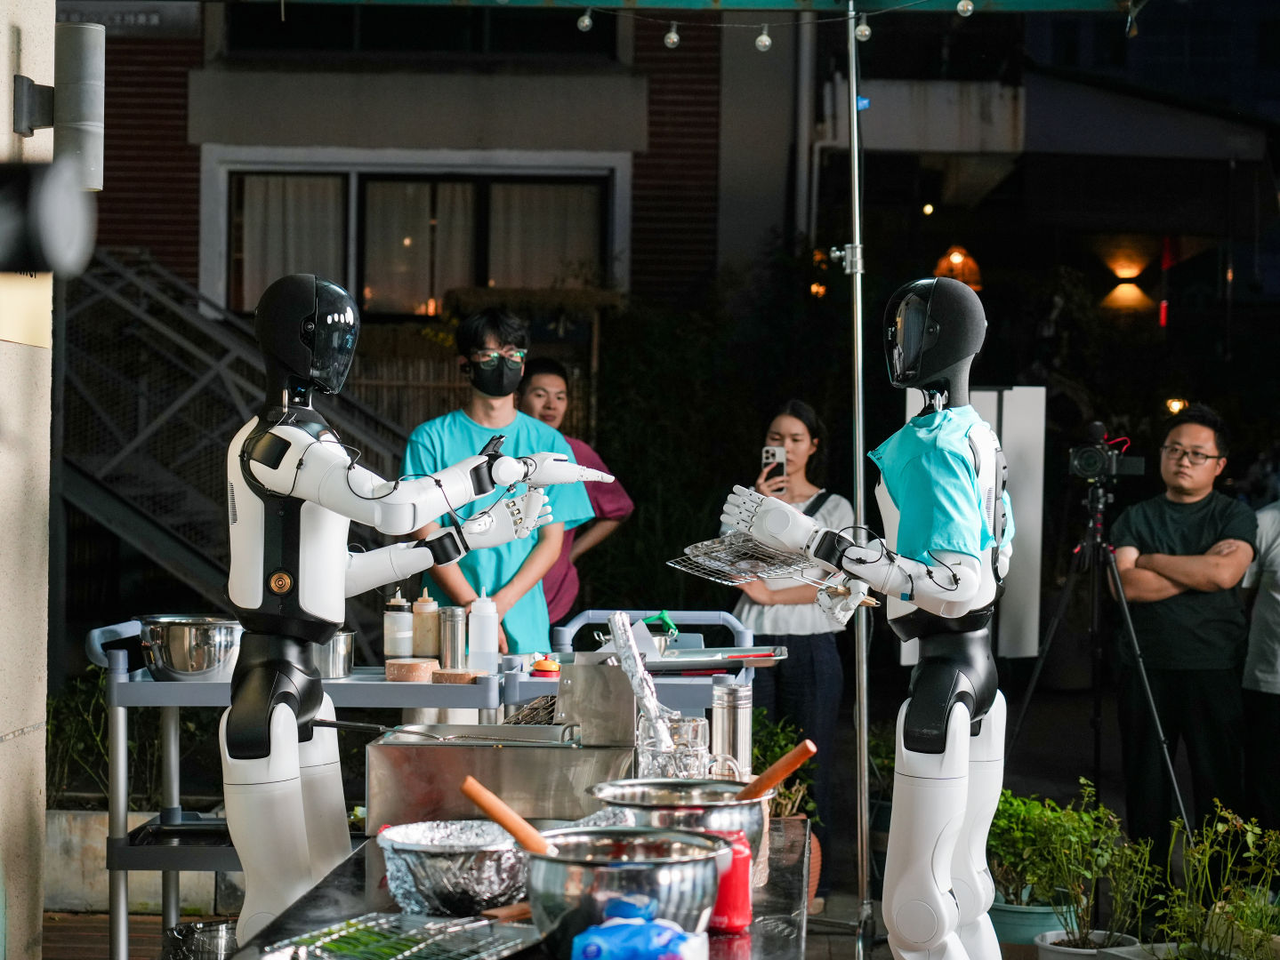
这不是一场科技秀那么简单,更值得看的是,这是一场具身行业很少见的"商用压力测试。这也是全球范围内,第一次有具身大模型敢接受这样的测试。
人形机器人最大的坎,是概念起飞,落地没机会
不少具身智能企业都在讲同一个故事:机器人要进入家庭了,进工厂了,进门店了,进入真实的生活了!发布会一场接着一场,现场玩的越来越花哨,宣传片里的机器人冲咖啡、叠衣服、收桌子,看起来距离"上岗"也就一步之遥。
但一到线下面基,就各种状况百出,“遥控器”成为出场率最高单品。其实,这也好理解,毕竟概念和落地之间,隔着的是一个真实、琐碎、不可预设的世界。
就拿和这场直播最接近的餐饮场景来说,桌椅摆法每天都不一样,地上随时可能有水渍,服务员和顾客从四面八方走过来,顾客点单到一半该注意了,还可能要突然喝水等等,每一步都要现场判断,没有一条路线能提前画好,需求是碎的、变的,它得记得住、排得开,一个没见过的调料瓶、一套新换的餐具,它得自己摸索着学会用。一个普通机器人看到这些会怎样?直接模型崩溃,躺平摆烂了。因为机器人很多模型现在走的路线,坦白来说还是语言大模型那套,先把看到的画面翻译成token,再把token翻译成动作。翻译每多一道,信息就丢一层、反应就慢一拍。但真实世界的变量是连续的、即时的,靠"翻译"根本接不住。
而乐享科技这场直播,偏偏就是把这些变量一样不少地摆上了台面,还是加量版本!
一场不怕"找茬"的测试
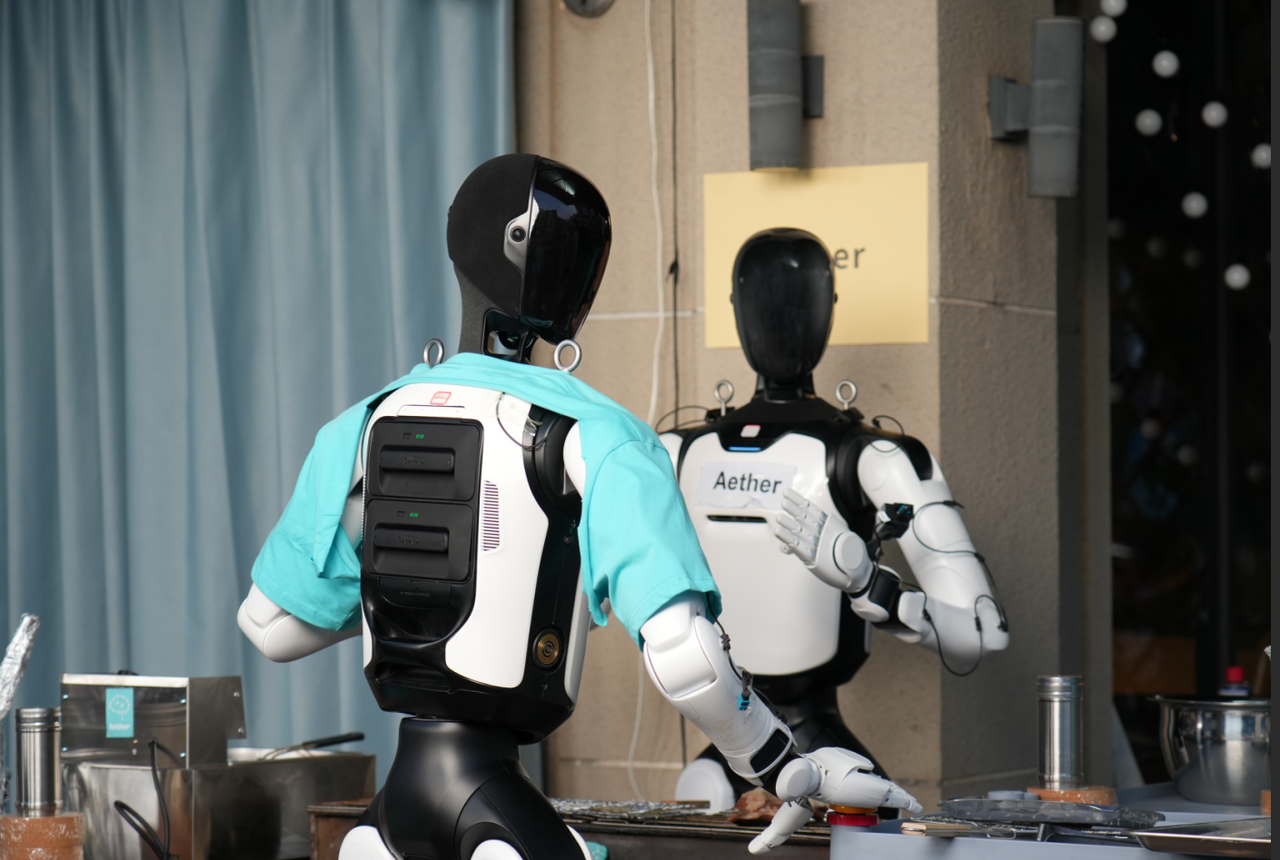
现场6名顾客可以随意挪动物品、打断服务、临时改需求。还有一位原定的顾客临时没来,乐享科技直接从围观人群里随机请了一位观众补位。没流程、没剧本,上场就出题。
这些"麻烦",在真实门店里其实每分钟都在发生。但以前对机器人来说就是天塌了。任务一旦被打断,别说继续执行,甚至有可能直接宕机。
可这场直播看下来,乐享这些"有脑子"的机器人是真的强。直播给人印象最深的是四个瞬间,一个比一个像人。
第一个是,一台机器人正在点单,顾客临时要一瓶水。搁以前的机器人,任务链一断,要么卡死,要么重来。以太大模型先把水送到,然后也不耽误后续继续服务点单,行话来说,这是流式记忆,也就是刚才在干嘛,它一直记着。
第二个是,两个不同机器人之间的跨本体协作。烤串和上菜两个机器人能互相配合,现在先烤什么菜,哪个熟了,可以出餐。以太大模型完美解释了“通用”二字的含金量,智能不再被硬件绑死,换个"身体"照样干活。
第三个是,烧烤时,机器人接收到客人的要求,精准且均匀的将调料撒到食物上面。
不是乱撒,而是精准的看到了食物所在的位置,将佐料撒在了食物上。
第四个是,机器人竟然还有“性格”。有一点就燃的暴躁型,有贴心守护的服从型。同样是递东西,暴躁型随手一放就走,服务型会在顾客打断时优先响应新需求。
几个瞬间连起来,其实就是一句话:打断扛得住,新东西学得会,协作搞得定,甚至还带点小性格。机器人更像“人”一样解决问题,而不是单纯执行程序,才是打开规模化应用的那把钥匙。
"能用"的门槛,被第一次公开跨过
为什么乐享的机器人没有"崩溃躺平"?答案藏在以太大模型选择的全新路线里。它没有走VLA那套主流路线,而是采用以神经元分配为核心的能量驱动架构,参照人类"大脑—脊髓"的贯通机制,把感知、记忆、推理、运动控制和物理反馈装进同一套连续闭环。
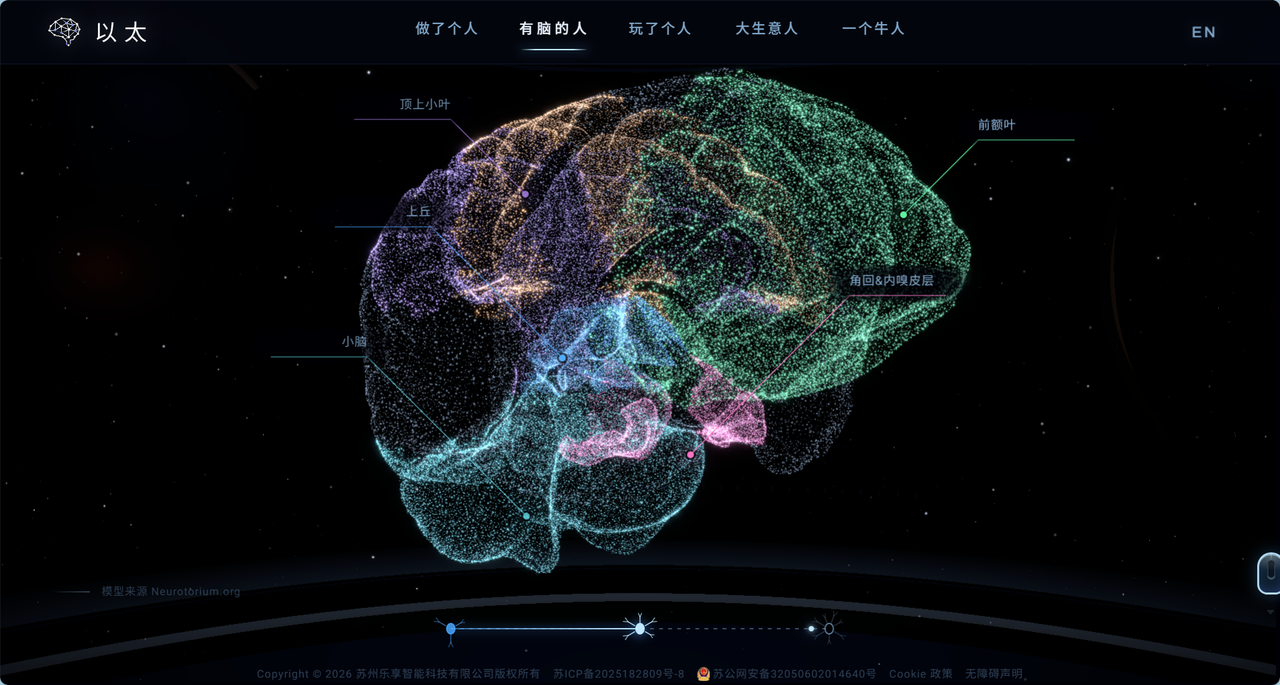
感知到行动之间没有"翻译"环节:力有多大、瓶子在哪里、手偏了几毫米,这些信号不需要被"概括成一句话"再转成动作,而是直接参与决策。少一道翻译,就少一层信息损耗,也快一拍反应。
一个值得反复咀嚼的数字是:该模型仅用200小时人类视频数据、零真机训练数据完成训练。不依赖海量真机数据采集,意味着未来落地在商业场景里,成本问题有望解决,而且解的不是"买一台机器人"的小钱,是"规模化铺开"的大钱。按传统路线,机器人每进一个新场景,就要重新采集数据、重新训练,这笔成本会跟着场景数量一路线性往上涨;而以太大模型只用200小时人类视频就完成了训练,进场之后还能自己学、自己变强。规模化的边际成本,被压到了极低。
说到底,烤串只是考题,真正重要的是答题的方式:被打断了记得回来接着干活、陌生物品试几次就上手、开放场地不用人领路。以太大模型让机器人第一次不像在执行程序,而像一个真正的人在干活。
除了技术创新本身,乐享科技引领的这条具身大模型方向,打开了落地新局面。这也让乐享拿下了具身大模型的领先身位:当多数同行还在演示视频里证明"做得到",乐享已经在真实世界里回答了"能不能一直做到"。具身大模型该往哪走、怎么走,第一个把路趟出来的,是乐享。这条路一旦跑通,具身智能商业化的时间表,恐怕要重新排了。
本文首发于 亿邦动力 官方网站
【版权提示】亿邦动力倡导尊重与保护知识产权。未经许可,任何人不得复制、转载、或以其他方式使用本网站的内容。如发现本站文章存在版权问题,烦请提供版权疑问、身份证明、版权证明、联系方式等发邮件至run@ebrun.com,我们将及时沟通与处理。
已点赞


{{ praise_text }}
好文章,值得被更多人看到
FAQ回顾
具身大模型实现商用落地主要面临哪些阻碍?
真实开放场景存在大量不可预设的动态变量,传统VLA路线的具身模型需多环节转译感知信号,易出现信息损耗、反应滞后、任务中断即宕机的问题,且高度依赖海量真机训练数据,规模化落地成本高昂。
乐享科技以太大模型有哪些核心技术优势?
它未走主流VLA路线,采用以神经元分配为核心的能量驱动架构,参照人类“大脑—脊髓”贯通机制搭建连续决策闭环,感知到行动无转译环节,信息损耗低、反应快,支持跨本体协作,具备流式记忆可抗任务中断。
以太大模型为什么能降低具身智能规模化落地成本?
该模型仅需200小时人类视频数据、零真机训练数据即可完成训练,落地新场景无需重新采集大量真机数据重训,进场后可自主学习迭代,能将规模化部署的边际成本压到极低。
可商用的具身服务机器人需要达到什么能力标准?
需能在无遥操作、无预设脚本的真实开放场景稳定工作,可动态响应临时改需求、物品移位等突发状况,支持多机协作,能快速识别操作陌生物品,灵活处理问题而非死板执行预设程序。
下一篇

Andrew Edlefsen致辞:企业不只要跟上变化 更要看清哪些变化真正重要
打造全球品牌,对接合适的市场与平台,并借助AI、数据和更智能的运营实现可持续增长。









