



从求量到提质 2025外滩大会探讨下一代数据基础设施
作者:龚作仁 文章来源:Laborer
2025-09-13 20:25
作者:龚作仁 文章来源:Laborer
2025-09-13 20:25

邦小白快读

可供大模型训练的人类数据越来越少,Scaling Law正在缓慢失效,智能的上限,如何再次突破?
9月12日,在2025 Inclusion·外滩大会“Data meets AI:智能时代的双引擎”见解论坛上,产学界的多位权威专家给出了新解法:数据驱动了AI发展,AI也让数据迎来了新一轮的进化,双引擎融合驱动才是演进方向。
论坛由中国人工智能学会、上海交通大学与蚂蚁集团联合主办。
高质量数据构建成为大模型发展的新突破口
数据作为智能时代的第一引擎,正从辅助角色转变为核心驱动力。
复旦大学教授肖仰华指出,当前大模型发展正面临严峻的"数据墙"困境,无标签语料对模型性能提升的贡献日益减弱,更大规模数据带来的性能提升与所需的训练开销相比性价比显著降低。他认为,大模型数据科学需要从专家经验阶段发展到量化科学、直至自进化阶段。“大模型的数据实践需要屠呦呦式的研究,从海量杂乱的数据中提取出决定模型能力的关键成分”。
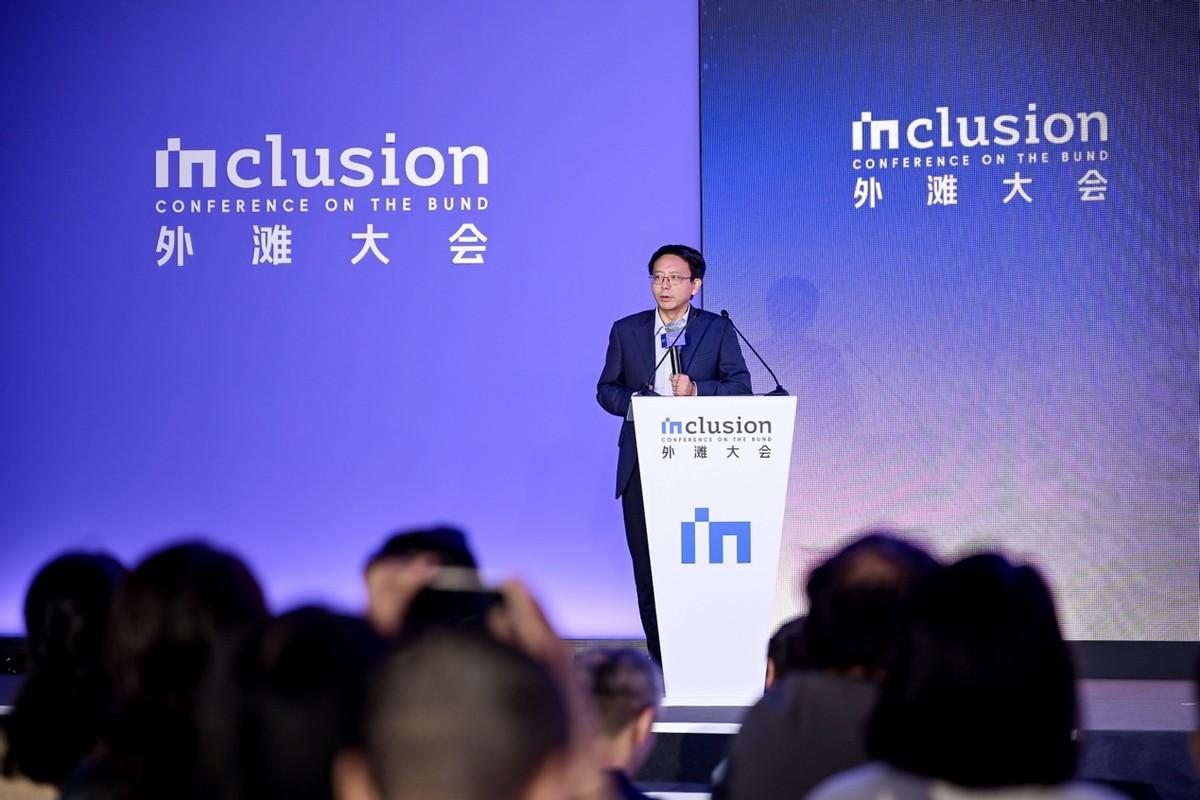
(复旦大学教授肖仰华)
肖仰华分享了通过语法复杂度指标和累积分布采样方法筛选高质量语料的实践,实验表明,从100亿个token的财经语料中仅筛选20%的高质量数据进行训练,对模型进行持续预训练,相比于全量数据持续预训练,在领域问答任务上的准确率提升1.7%。
上海交通大学特聘教授翟广涛强调无论是精炼数据还是合成数据,都需要质量优先,而数据质量分析要从“体验质量”入手,考虑人的体验,也考虑机器的体验,进而在数据为中心的范式下进一步提升大模型性能。
海天瑞声CEO李科从产业实践角度分享了全球AI数据行业的发展趋势。他认为,数据产业正在经历从劳动密集型向技术密集型和知识密集型的重大转型。通过动捕数据、自动驾驶标注、思维链数据集等多个实际案例,李科展示了高质量数据如何服务千行百业。
上海库帕思科技有限公司董事长山栋明说,模型之变引领“数据质变”,他表示高质量数据集应满足VALID²(鲜活度、真实性、大样本、完整性、多样性、高知识密度)要求,并详细介绍了语料数据在方法论、基础设施和行业生态三个方面的体系化重构探索。
技术创新推动数据价值释放
作为第二引擎,AI技术正在深刻改变数据处理和利用的方式。
光轮智能总裁杨海波表示,具身智能对数据的需求量是大语言模型和自动驾驶的上千倍。合成数据是实现具身智能Scaling Law的重要基础,他强调,合成数据必须满足四个必备条件:真实的物理交互、人在环的示范、场景足够丰富和数据闭环验证。杨海波认为,“站在岸上学不会游泳”,机器人需要进入物理可交互的环境去获取物理世界反馈来优化模型。
蚂蚁技术研究院数据智能实验室负责人赵俊博认为,下一代RL训练法则应该从“对与错”转向“好与更好”。"他探索的"Rubric即Reward"新机制,只需使用5k数据和1万条评分标准构建高效RL回路,就能摆脱对海量SFT数据的依赖,实现"品味对齐"。他说,这种方法可以在人文、创意、情感等领域实现风格化生成,去除"机器味道"。
LanceDB CTO徐磊分享了开源多模态数据湖的创新实践。他介绍,与传统的Parquet、ORC等格式不同,新设计的Lance格式既是文件格式又是表格式,具备零拷贝数据演化和高效点查两大核心特性。徐磊举了Runway ML的案例,该公司将PB级视频数据导入Lance后,能够像使用SQL一样简单管理,实现30多位AI工程师在同一个主表上并行进行特征工程迭代。
NVIDIA互联网解决方案架构高级总监陈川介绍了驱动生成式AI的高效数据处理创新,分享了从文本到多模态的GPU加速解决方案。
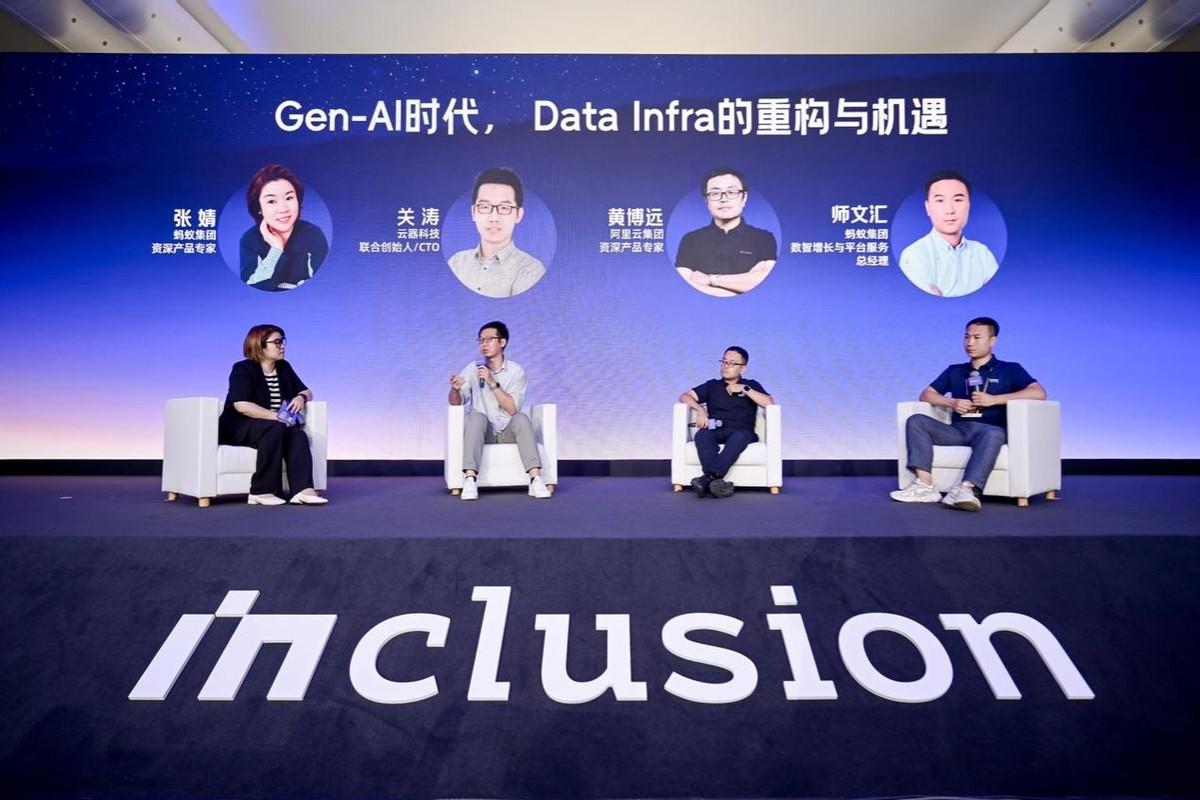
在圆桌讨论环节,专家围绕展开Data Infra的重构与机遇深入讨论。专家一致认为,随着计算范式的变化,数据处理技术无论主动还是被动,都需要重构与再定义。重构是为了解决已经面临的问题,再定义则是着眼于未来,解决可能面临的问题。
本次论坛展示了数据与AI双引擎协同发展的最新成果,为智能时代数据基础设施建设提供了参考和实践路径。与会专家表示,只有实现数据与AI的深度融合,建立完善的数据标准体系和质量评估框架,才能真正释放智能技术的巨大潜力,推动智能时代向更高层次发展。
注:文/龚作仁,文章来源:Laborer,本文为作者独立观点,不代表亿邦动力立场。
【版权提示】亿邦动力倡导尊重与保护知识产权。未经许可,任何人不得复制、转载、或以其他方式使用本网站的内容。如发现本站文章存在版权问题,烦请提供版权疑问、身份证明、版权证明、联系方式等发邮件至run@ebrun.com,我们将及时沟通与处理。
已点赞


{{ praise_text }}
好文章,值得被更多人看到
FAQ回顾
2025外滩大会讨论了哪些数据与AI融合的新方向?
大会提出数据与AI双引擎协同发展,重点包括高质量数据筛选(如语法复杂度指标采样)、合成数据应用(需满足物理交互等四条件)和新型RL训练机制(如Rubric即Reward方法),推动数据基础设施从量向质转变。
高质量数据集应满足哪些核心标准?
需符合VALID²框架:鲜活度、真实性、大样本、完整性、多样性、高知识密度。例如从100亿token语料中筛选20%高质量数据,可使模型领域问答准确率提升1.7%。
AI技术如何革新数据处理方式?
通过Lance格式实现零拷贝数据演化和高效点查;Rubric即Reward机制仅用5k数据即可构建RL回路;合成数据支撑具身智能,需求量为传统AI的上千倍。
- 标签:
- 业界
下一篇


齐心集团CTO于斌平:用大模型解决B2B采购中的七大问题
齐心集团董事、CTO于斌平作为嘉宾出席活动并发表《AI大模型赋能的数字化采购新模式》分享。









