



MiniMax加码多模态:视频模型面世 底层架构升级
作者:胡镤心 文章来源:亿邦动力
2024-09-02 18:15
作者:胡镤心 文章来源:亿邦动力
2024-09-02 18:15

邦小白快读


【亿邦原创】每个人心中都有一个魔法世界。
小男孩Will的书桌上落下一杯金币,每次触摸金币,他都会穿梭不同空间:有时候他是走向城堡的少年骑士,有时候他是悬崖上与巫师搏斗的少年勇士,前一瞬他还在骑着北极熊在冰川上前行,后一瞬他已经乘着巨龙穿梭在电闪雷鸣中……每一个世界都栩栩如生,每个世界他都在经历意想不到的惊喜。
“Mom,I’ve got magic!”Will欢呼。这枚神奇的金币带他走进无数个幻想世界,这枚金币到底什么来头?金币翻转,上刻着几个单词:MiniMax。
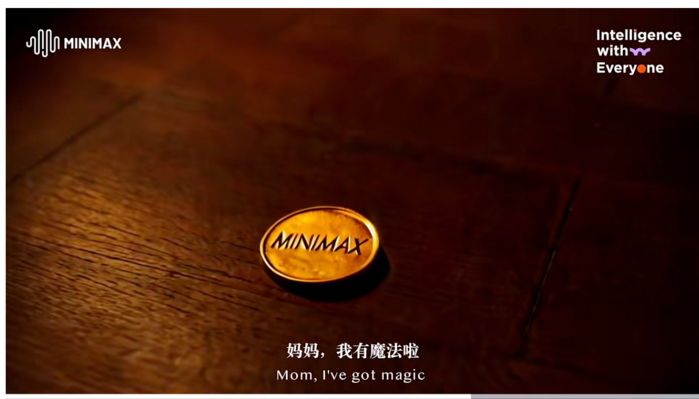
这是MiniMax最新款视频模型生成的将近2分钟的小男孩奇幻世界环游记。
8月31日,在MiniMax Link伙伴日上,MiniMax创始人、CEO闫俊杰发布了这款AI高清视频生成模型技术:abab-video-1。这是MiniMax继文本、音乐、声音之后发布的又一款AI模型,目前可以在海螺AI中免费使用,最高支持原生1280*720的25fps,生成时长6秒。
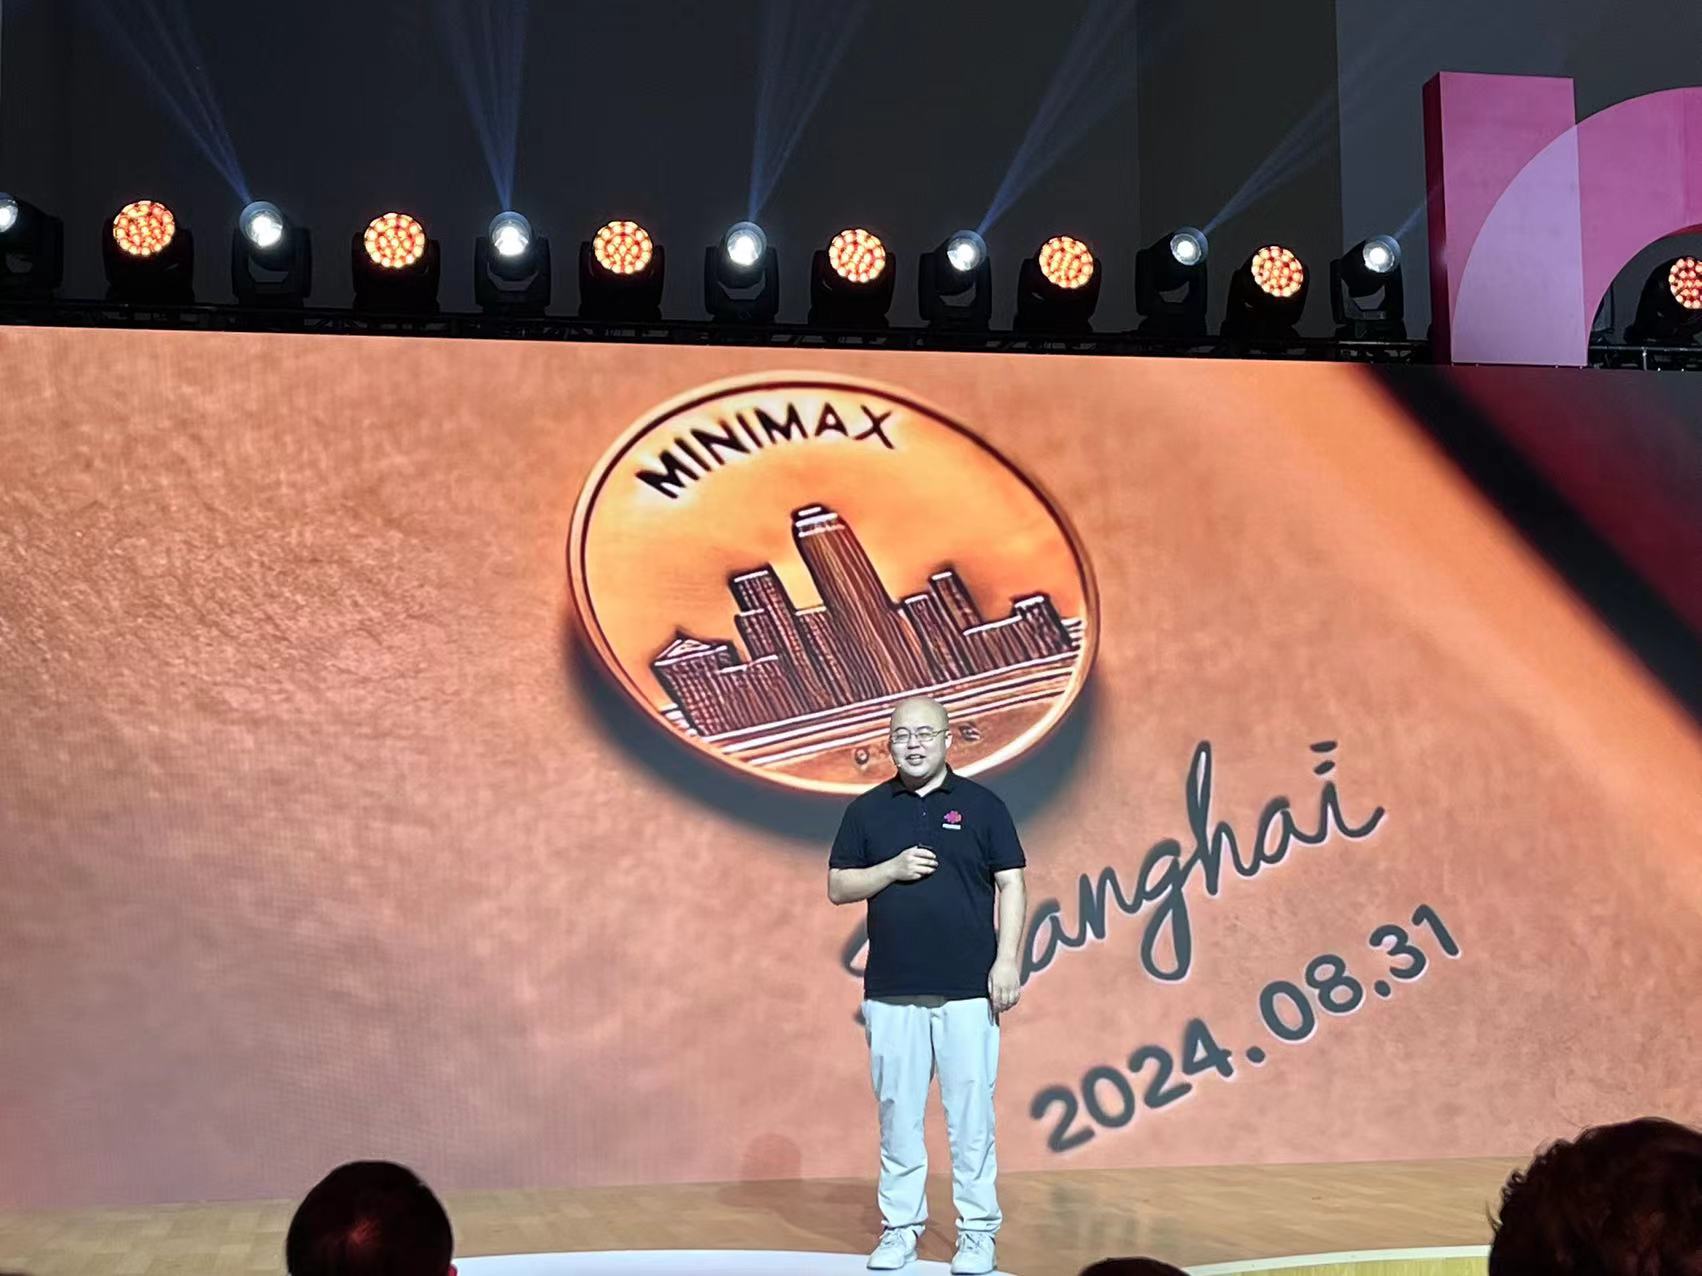
闫俊杰透露,这款视频模型研发时间近一年,一周前刚完成,“我们第一次把它做出来就跑了一个分数,它是benchmark上最好的视频模型。”
此外,MiniMax还推出音乐模型,可以合成纯音乐,帮制作人快速构建歌曲的基本结构,由歌手自由演绎主唱或和声部分。目前MiniMax语音模型已实现对粤语、日语、韩语、西班牙语等多语种支持的升级。
视频模型和音乐模型背后是MiniMax底层模型的进一步突破。闫俊杰介绍,MiniMax持续在模型算法上做创新,并推出基于MOE(混合专家)+Linear Attention(线性注意力)的新一代模型技术。
Linear Attention是一种一种新型的线性注意力机制,在遇到显存瓶颈之前,无限增大序列长度并不会对于模型训练速度产生负面影响。这让无限长度的输入和输出成为了可能。通过新型线性模型架构,MiniMax大模型能在单位时间内更加高效地训练海量数据,极大地提升了模型的实用性和响应速度。
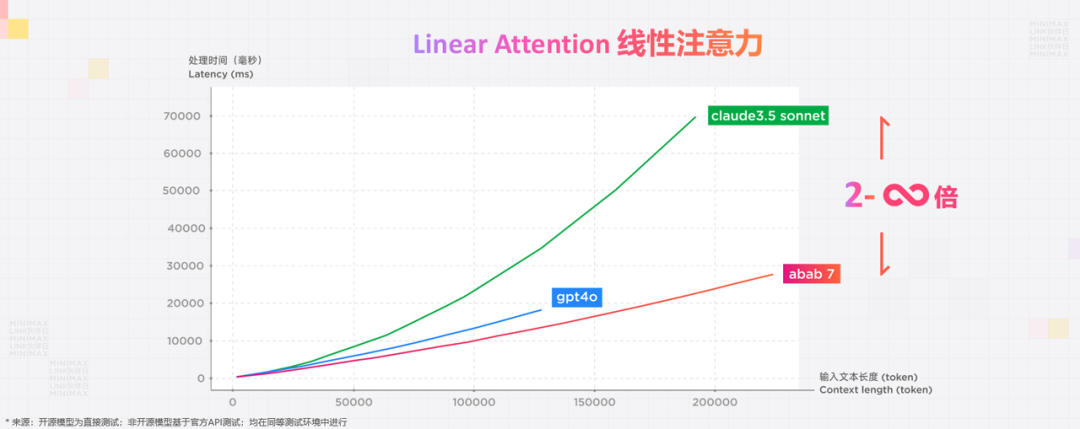
在与GPT-4o同一代模型能力对比上,新一代模型处理10万token时效率可提升2-3倍,并且随着长度越长,提升越明显。相比于通用Transformer架构,新架构的原生线性计算复杂度大幅减少了大模型的训练和推理成本。在128K的序列长度下,新架构成本减少90%以上。
同时,闫俊杰还预告,基于MOE+Linear Attention的文本模型abab 7将于未来数周内正式发布。
亿邦持续追踪报道该情报,如想了解更多与本文相关信息,请扫码关注作者微信。
【版权提示】亿邦动力倡导尊重与保护知识产权。未经许可,任何人不得复制、转载、或以其他方式使用本网站的内容。如发现本站文章存在版权问题,烦请提供版权疑问、身份证明、版权证明、联系方式等发邮件至run@ebrun.com,我们将及时沟通与处理。
已点赞


{{ praise_text }}
好文章,值得被更多人看到
FAQ回顾
MiniMax新发布的视频模型abab-video-1有哪些核心参数?
MiniMax abab-video-1视频模型最高支持原生1280*720分辨率、25fps,可生成6秒时长的视频。该模型研发近一年,目前可在海螺AI中免费使用。
什么是MOE Linear Attention架构?它有哪些优势?
MOE Linear Attention是一种新型线性注意力机制,可无限增大序列长度而不影响训练速度。相比通用Transformer,在128K序列长度下训练和推理成本降低90%以上,处理10万token时效率提升2-3倍。
MiniMax在语音和音乐模型方面有哪些新进展?
MiniMax语音模型已升级支持粤语、日语、韩语、西班牙语等多语种。音乐模型可合成纯音乐,帮助制作人快速构建歌曲结构,支持歌手自由演绎主唱或和声。
- 标签:
- 产业互联网
下一篇











