



登顶 HF 热榜、下载达20万:有道「子曰4 -R2T2」模型技术报告发布
作者:龚作仁 文章来源:Laborer
2026-11-05 16:15
作者:龚作仁 文章来源:Laborer
2026-11-05 16:15

邦小白快读

开源仅4 天(9月21日),网易有道子曰Confucius4-R2T2就登顶Hugging Face自动语音识别(ASR)热榜第一。目前,模型及各量化版本全球累计下载量已达到20万次。
围绕R2T2,社区陆续推出量化版本与不同运行环境的适配,让更多开发者能够体验高质量的实时语音转写能力。近日,Confucius4-R2T2的技术报告也上线论文预印本平台arXiv。
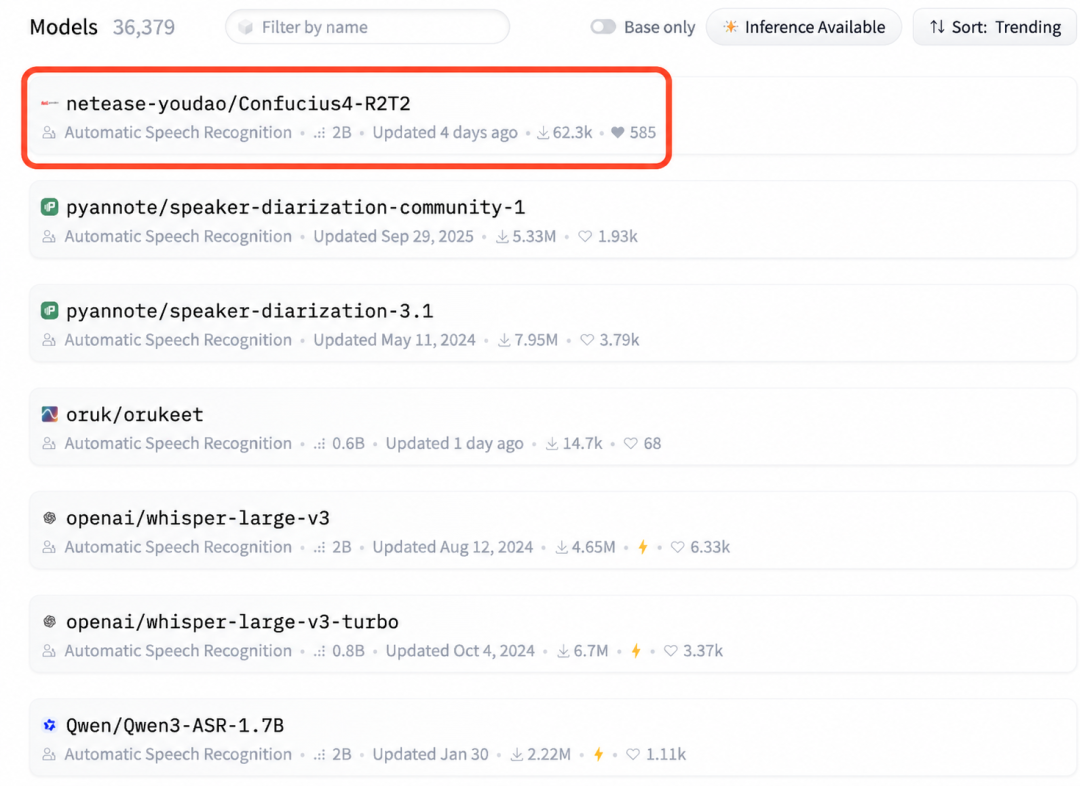
主模型下载量达6万2,其他量化版本下载量合计约14万
这份关注背后,是实时语音应用对“快、准、稳”的共同需求。
对实时字幕、同声传译和语音智能体而言,识别结果不仅要准确,还要及时、稳定。一段已经交给下游处理的文字,如果随后被改写,就可能引发字幕跳动、译文重写或重复推理。
因此,R2T2关注的不只是“识别出了什么”,还有一个同样关键的问题:一段话尚未说完,哪些文字已经可以提交?
输出太早,可能因为信息不完整而识别错误;等待太久,又会拖慢后续翻译与交互。R2T2——Real Real-Time Transcription——围绕这一矛盾展开:让模型学会在证据充分时提交文字,在信息不足时继续等待,已经提交的文本保持不变。
报告通过最长稳定前缀监督、显式等待与流式提交策略,将“何时输出”纳入模型的学习与推理过程,探索如何在不回改已提交文本的条件下,兼顾识别质量与输出速度。
技术报告地址:https://arxiv.org/abs/2611.06043
最长稳定前缀(LSP):把“何时提交”纳入训练
R2T2基于Qwen3-ASR-1.7B构建,在不改变模型架构的前提下,通过约1500小时中英文音频的后训练,学习流式识别与稳定提交。
核心方法是Longest Stable Prefix,最长稳定前缀,简称LSP。
普通语音识别训练数据通常只有“音频—完整文本”配对,并没有直接告诉模型:听到哪个时间点,哪些文字已经足够稳定,可以立即提交。
R2T2为此构造部分音频下的监督信号:先用同一个基础模型识别完整音频,得到参考输出,再以80ms间隔逐步输入音频前缀,记录各个时刻的识别结果。
在某个时间点,LSP选取的是:截至当前,模型曾经完整输出过、且整体与完整音频输出的开头一致的最长文本。
这一要求意味着,训练标签需要来自模型实际产生过的一次完整识别结果,而不是从带有错误尾部的结果中任意截取一段。随着音频增加,已经确定的LSP也不会因为后续一次识别波动而缩短。
以“I have two cats”为例,当系统只听到部分音频时,可能把“two”识别为“to”或“too”;随着更多音频到来,正确表达才逐渐明确。LSP的构造过程是:
当“I have”已经形成与完整参考一致的输出时,可以将其作为稳定前缀。
当后续识别在“to”“too”之间变化时,保留已经确定的前缀,暂缓不确定的续写。
随着更多音频到来,再将稳定前缀扩展到“I have two”,直至完整句子。
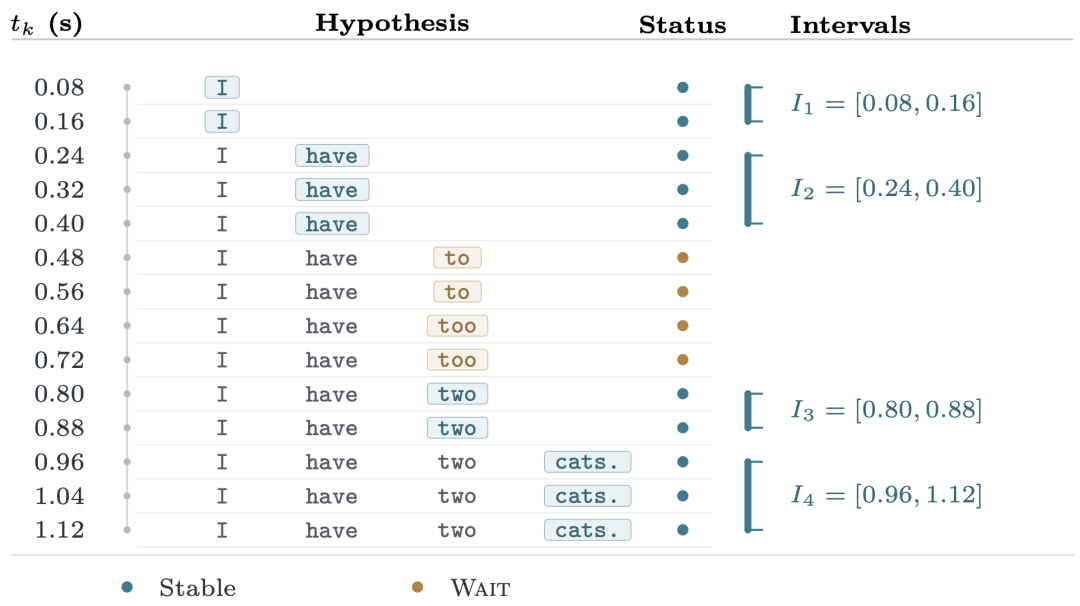
逐步输入音频后,模型输出在稳定前缀与不确定续写之间变化。蓝色表示与稳定前缀一致的预测,橙色表示需要继续等待的续写。
为表达“还需要继续听”,R2T2引入显式的WAIT行为。训练时,落在稳定区间内的音频截断位置用于监督稳定文本输出;落在区间间隙中的位置,则在稳定前缀之后加入WAIT,指导模型停止当前轮次的生成,等待更多音频。
这样,模型同时学习两件事:当前听到了什么,以及当前可以提交到哪里。
报告还从理论上说明了LSP的性质:它随音频推进保持前缀单调增长,在完整音频处与参考输出一致,并且在满足上述约束的候选标签中具有最大性。由此,“何时输出”获得了明确的训练目标。
R2T2的训练分为监督微调和强化学习两个阶段。两个阶段均冻结音频编码器与投影层,仅更新语言解码器参数,保留预训练的声学表征及其映射,将适配重点放在识别输出与提交时机上。
第一阶段,学习稳定前缀与WAIT。
监督微调帮助模型适应部分音频输入,学习何时输出文字、何时继续等待。训练中,90% 的样本采用音频前缀截断,另外10% 保留完整音频与完整转写,让模型在学习流式行为的同时,继续接受完整转写任务的监督。
第二阶段,进一步优化识别与等待行为。
在监督微调基础上,R2T2使用GRPO强化学习,通过多轮流式生成评估模型随着新音频到来如何继续输出。奖励综合考虑识别准确性、冗余内容、长度、重复、语言一致性、尾部续写、局部词级匹配,以及WAIT标记的位置等因素。
这些设计对应着实时应用中的常见问题:生成没有说出的文字、重复输出、过度补全尾部,或者把转写误做成翻译。
训练还引入噪声、混响和纯噪声负样本,帮助模型适应复杂声学条件;部分样本会改变语言标签、保持转写目标不变,促使模型更多依赖实际音频内容。
稳定提交要求模型在文字发布前作出判断,因此,减少过早提交造成的错误、避免缺乏音频依据的生成,是训练的重要目标。
从训练到推理,R2T2还需要将这一能力落实到持续运行的语音系统中。训练提供识别与等待的行为基础,推理时则通过提交策略保持已发布文本不变。报告同时结合缓存复用、有界上下文和暂定尾部验证,减少流式更新中的重复计算,并通过音频块大小与暂定尾部长度,为不同应用提供可调节的质量与延迟选择。下面的实验进一步展示了这些选择对应的表现。
实验表现:在稳定提交约束下兼顾识别质量
报告在8 个英文测试集和5 个中文测试集上进行主评估,覆盖朗读、会议、演讲及真实同传语音等场景。英文采用词错误率WER,中文采用字错误率CER,数值越低,表示识别错误越少。
首先看识别质量。R2T2提供两种不同的推理配置:
质量优先(U=1):将末尾1 个token暂留在模型内部,允许结合后续音频重新判断,再对外提交。
低延迟(U=0):不额外保留这一暂定尾部,侧重更早输出。
两种配置对外都只提供已提交文本,已经提交的内容均不回改。以下为结果:
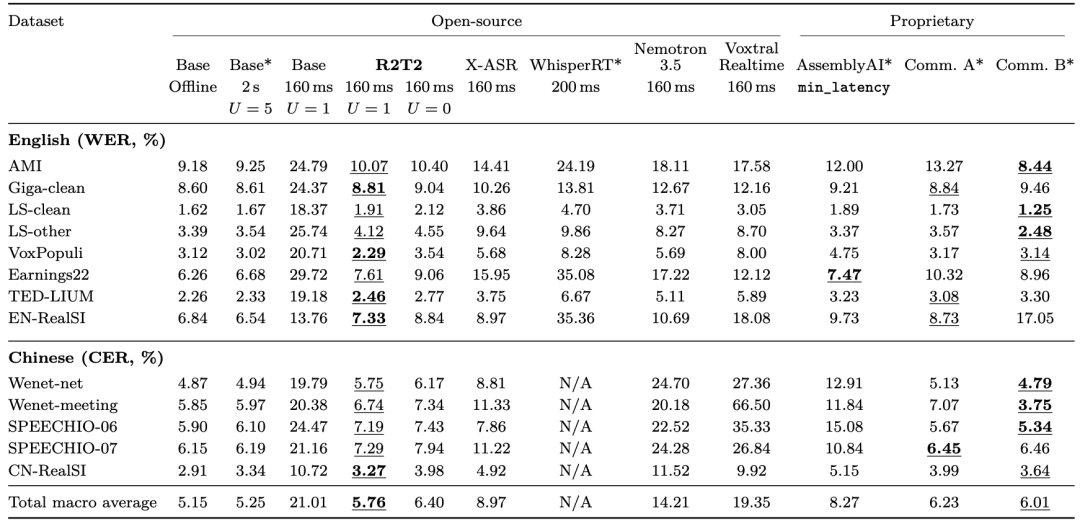
以上配置均采用160ms音频块,结果对应报告中的模型版本、测试集与推理设置。
在全部13个主测试集上,质量优先配置的综合宏平均错误率为5.76%,低于X-ASR的 8.97%,也低于报告评测的三款商业API。
在报告评测设置下,R2T2质量优先配置在全部13个主测试集上的识别错误率,均低于参与排名的其他开源流式模型配置。
综合宏平均是对各测试集的WER或 CER百分比等权取平均。完整音频和2 秒音频块的基础模型配置仅作为参考,不纳入上述排名。
与同样采用160ms、U=1配置的基础模型相比,R2T2将综合宏平均错误率从21.01% 降至5.76%,与基础模型完整音频识别结果的差距缩小至约0.6个百分点。这表明,针对性的后训练能够显著改善小音频块条件下的识别表现,让稳定的流式输出接近完整音频识别的质量。
再看文字何时能够稳定输出。
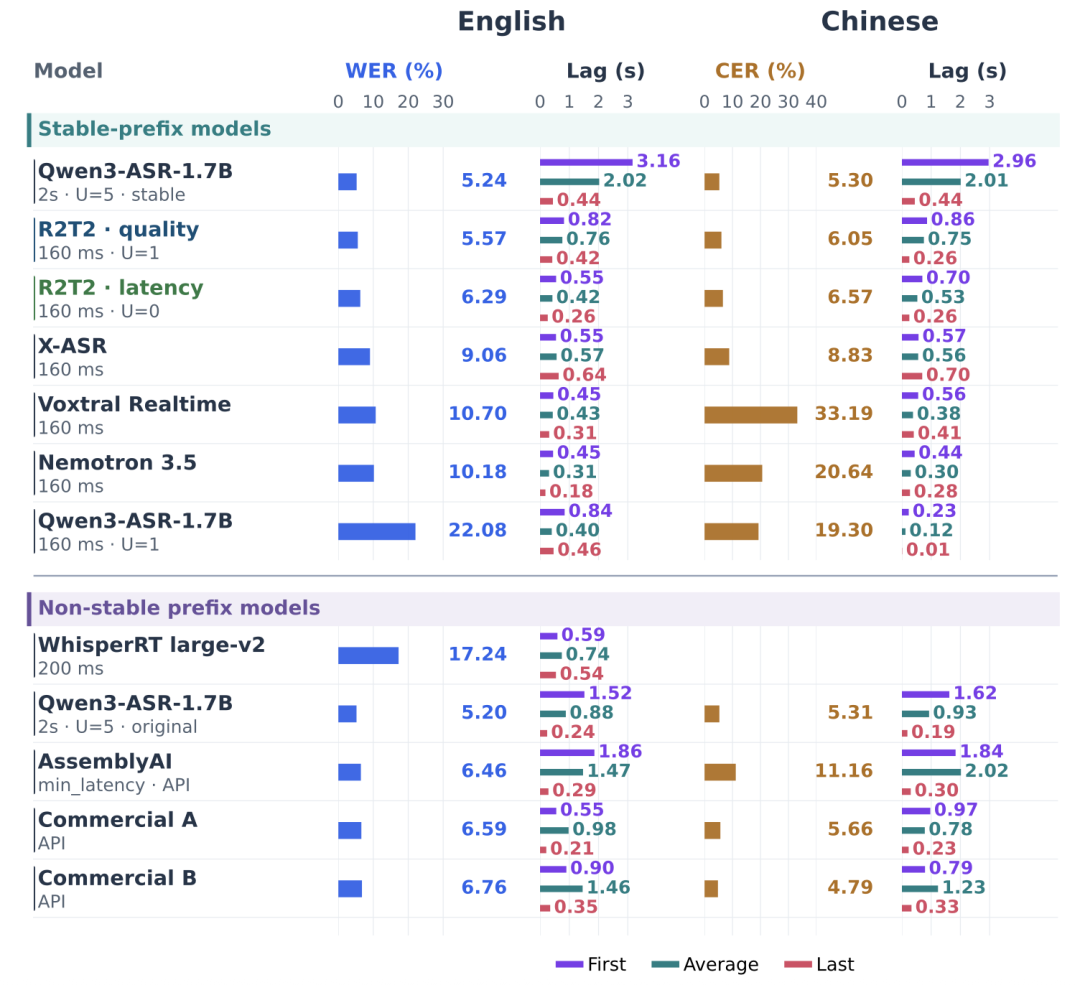
不同配置下的英文WER、中文CER与回溯输出延迟。Average表示平均延迟,First和 Last分别对应首个、末个匹配单元的延迟。
在160ms音频块、低延迟配置(U=0)下,R2T2的中文和英文平均回溯输出延迟分别约为0.53秒和0.42秒。质量优先配置通过稍晚提交,进一步降低识别错误率,对应的中文和英文平均延迟分别约为0.75秒和0.76秒。
进一步采用80ms音频块、U=0时,两种语言的平均回溯输出延迟均低于0.5秒,同时在识别质量上作出一定取舍。同一个模型无需重新训练,就能根据应用需求调整质量与输出速度。
最后看能力能否迁移到更多语言。
虽然后训练仅使用中英文数据,但在另外10种语言的18个测试集上,R2T2在相同的160ms、U=1设置下,识别错误率均低于基础模型。这说明,流式识别能力的提升能够迁移到后训练语言之外。
从识别质量、输出延迟到跨语言迁移,这些结果共同展示了R2T2的技术价值:在保持已提交文本不变的前提下,让实时语音应用更早获得准确、可持续使用的增量输入。
从实时转写,走向更多语音应用
稳定的增量文本,是实时语音应用连接声音与后续处理的重要基础。
在字幕与听写中,它有助于减少已提交文字反复修改带来的阅读干扰;在同声传译中,它可以为下游翻译提供持续增长的稳定内容;在语音助手与智能体中,它让理解与处理有机会更早开始,降低对整句转写完成的依赖。
开源之后,围绕R2T2出现的社区量化与运行环境适配,进一步拓展了模型的使用方式。从本地实时听写,到不同场景下的评测与应用开发,社区的探索让模型获得更多真实环境中的验证,也为后续优化提供了反馈。
R2T2也是网易有道子曰模型矩阵在实时语音识别方向的重要组成部分。围绕多模态理解与推理、实时语音识别、流式翻译和语音生成,网易有道已陆续推出多款各有侧重的模型:
Confucius4多模态模型:面向视觉理解与数理推理,支持结合文本和图像进行问题分析与求解。
Confucius4-R2T2实时语音识别模型:将持续到来的语音转化为稳定的增量文本,为实时字幕、同传和语音交互提供输入。
Confucius4-T3PO流式翻译模型:根据不断输入的文本,动态决定继续等待还是输出译文;可与R2T2串联,支持语音同传场景。
Confucius4-TTS语音合成模型:支持14种语言的语音生成,以及无需参考音频转写文本的音色克隆,为多语言语音表达提供支持。
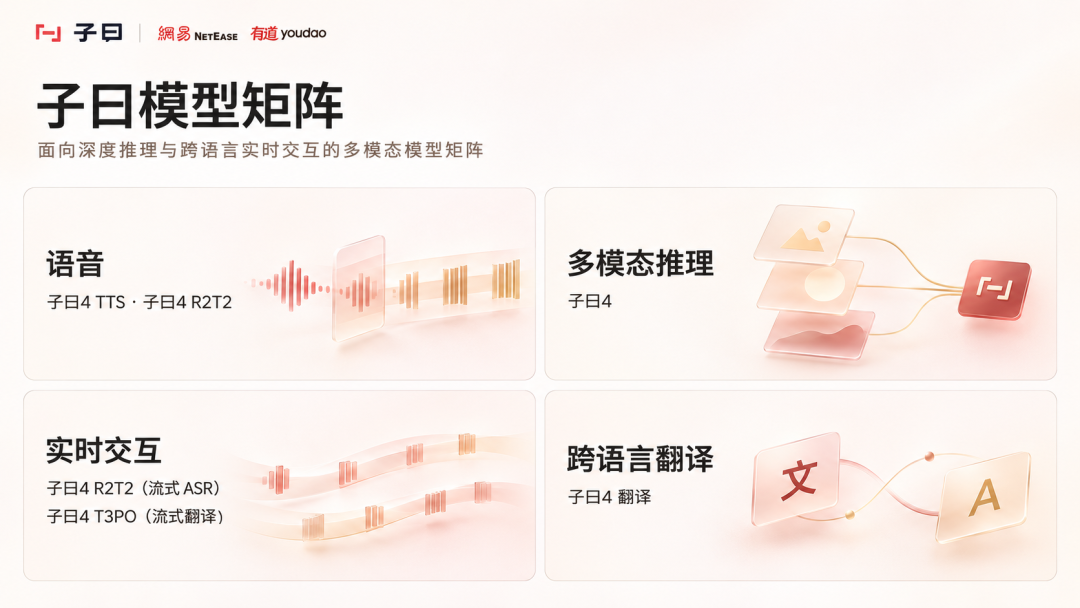
模型为开发者提供了覆盖“听、理解、翻译、表达”的能力。我们也希望与社区共同探索实时语音技术的更多可能。
技术报告链接:https://arxiv.org/abs/2611.06043
开源项目地址:https://huggingface.co/netease-youdao/Confucius4-R2T2
注:文/龚作仁,文章来源:Laborer,本文为作者独立观点,不代表亿邦动力立场。
【版权提示】亿邦动力倡导尊重与保护知识产权。未经许可,任何人不得复制、转载、或以其他方式使用本网站的内容。如发现本站文章存在版权问题,烦请提供版权疑问、身份证明、版权证明、联系方式等发邮件至run@ebrun.com,我们将及时沟通与处理。
已点赞


{{ praise_text }}
好文章,值得被更多人看到
FAQ回顾
Confucius4-R2T2是什么模型?
Confucius4-R2T2是网易有道推出的实时语音识别模型,基于Qwen3-ASR-1.7B构建,使用约1500小时中英文音频进行后训练,重点学习流式识别与稳定提交。模型开源后登顶Hugging Face自动语音识别热榜,全球累计下载量达20万次。
实时语音识别如何避免已输出字幕反复修改?
R2T2通过最长稳定前缀LSP训练模型判断哪些文字已经稳定可提交,并引入显式WAIT在信息不足时继续等待,已提交文本保持不变。推理阶段结合提交策略、缓存复用、有界上下文和暂定尾部验证,减少字幕跳动、译文重写和重复推理。
Confucius4-R2T2的识别质量和延迟表现如何?
在13个主测试集上,质量优先配置的宏平均错误率为5.76%,低于X-ASR的8.97%及报告评测的三款商业API。160ms音频块低延迟配置中英文平均回溯输出延迟约0.53秒和0.42秒,质量优先配置约0.75秒和0.76秒;80ms音频块U=0时均低于0.5秒。
Confucius4-R2T2适合哪些实时语音场景?
适用于实时字幕、听写、同声传译、语音助手和智能体等场景。稳定增量文本可减少已提交字幕反复修改带来的阅读干扰,为下游翻译提供持续增长的稳定内容,并让语音理解更早开始,降低对整句转写完成的依赖。
网易有道子曰模型矩阵包含哪些模型?
包括Confucius4多模态模型,面向视觉理解与数理推理;Confucius4-R2T2实时语音识别模型,输出稳定增量文本;Confucius4-T3PO流式翻译模型,可动态等待或输出译文并与R2T2串联;Confucius4-TTS语音合成模型,支持14种语言和音色克隆,覆盖听、理解、翻译、表达。
下一篇

亚马逊墨西哥站推出高端品牌专区Premium Hub 从美妆扩展至多品类
前,亚马逊墨西哥站推出高端品牌专区Premium Hub,将美妆、时尚、电子产品、家用电器、运动、相机、科技以及酒水等多个品类的高端品牌集中展示。









