



Scalabot发布HERON-CRA:从理解世界 到自主行动
作者:龚作仁 文章来源:Laborer
2026-09-16 10:21
作者:龚作仁 文章来源:Laborer
2026-09-16 10:21

邦小白快读

一周前,Scalabot发布了HERON技术架构体系下的首个模型——HERON-World Model,让机器人学习世界、预演未来。但对于真正进入真实世界的机器人来说,这只是开始。
真实世界并不会按照预设的轨迹运行。物体会移动,环境会变化,任务会被打断,机器人也难免出现偏差。一次细微的位移、一次意外的碰撞,都可能让原本正确的动作逐渐偏离目标,最终导致整个任务失败。
因此,一个真正具备通用操作能力的机器人,不仅要知道应该怎么做,还需要知道:如果现实没有按照预期发生,接下来应该怎么办?
它需要记住过去发生了什么,判断自己距离目标还有多远,在错误中学习并修正行动,更要把一次真实世界中的经验,转化为下一次的能力。
基于这一思考,9月15日,Scalabot发布HERON技术架构体系下的第二个模型——HERON-Context Reinforcement Action Model(CRA)。
如果说HERON-World Model让机器人开始学习世界、预演未来,那么HERON-CRA则是进一步让机器人能够记住过去、从错误中学习,并将一次经验转化为下一次能力。
围绕这一目标,HERON-CRA构建了Context Expert、RL Engine与Cross-Embodiment Pretraining三项关键能力:让机器人理解任务如何发生,从错误中持续修正,并将学到的能力跨越不同身体与任务进行迁移。
从“会做”,到“会学习”,再到“越做越好”,HERON-CRA让机器人进一步具备了一套能够在真实世界中持续进化的行动能力。
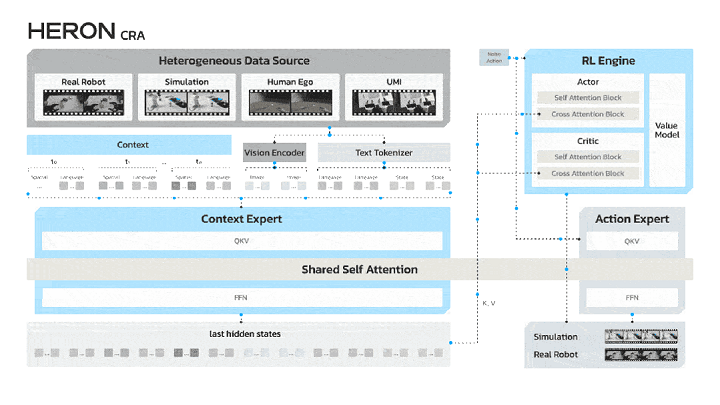
HERON-CRA技术框架
Context Expert:让机器人记住过去,理解任务如何发生
Context Expert
对于机器人来说,真正复杂的操作往往不是一个动作,而是一段连续发生的任务过程。
拿起一个杯子很简单,但如果任务是整理桌面、制作咖啡,或者叠好一双袜子,机器人需要连续完成几十个步骤。此时,仅仅理解眼前这一刻发生了什么远远不够。
它还需要知道:刚才发生了什么?物体原来在哪里?哪些步骤已经完成?环境又是如何一步步变化到现在的?
这也是当前主流VLA模型面临的一个重要挑战。它们能够很好地理解当前画面和语言指令,却很难仅凭当前观测完整还原一段任务的过程。对于长程任务,机器人需要的不只是“看见”,还需要“记住”。
HERON-CRA所具备的关键能力Context Expert,就是为机器人建立这样一套持续的时空记忆。
与简单堆叠历史图像不同,Context Expert将历史时刻的空间信息与语义信息编码为结构化的Context Token,并沿时间维度形成连续的4D时空上下文。其中,Spatial Token记录环境与物体的三维空间信息,Language Token保留对应场景的语义信息。模型因此能够同时关注“发生了什么”以及“它发生在哪里”。
这段时空上下文会与机器人当前看到的画面和任务指令共同参与动作决策。于是,机器人的每一步行动不再只是对当前画面的瞬时反应,而是建立在对整个任务过程的理解之上。
更重要的是,这种Context不仅让机器人能够记住过去,也让历史信息真正参与对当前任务的理解。面对新的任务或新的场景,机器人可以利用已有的上下文快速建立对当前情境的理解,而不必每一次都从零开始。
从“看到现在”,到“理解发生过什么”,Context Expert让机器人开始拥有了一段属于自己的任务记忆。
RL Engine:让机器人从错误中学习,持续修正行动
对于真实世界中的机器人来说,“会做”并不意味着“每次都能做好”。
在理想环境中,机器人可以按照示范完成一项任务。但进入真实世界后,物体的位置可能发生变化,动作可能出现偏差,甚至一次细微的误差,都可能让后续步骤逐渐偏离目标。
传统的模仿学习更擅长回答应该怎么做,却很难回答另一个同样重要的问题:如果刚才做错了,下一步应该怎么修正?
HERON-CRA的RL Engine,就是为了让机器人具备这样的自我修正能力。
它首先需要让机器人知道:自己现在做得怎么样,距离任务成功还有多远。为此,HERON-CRA引入Value Model,不再只判断一个动作成功还是失败,而是结合任务最终结果与连续的时序变化,为每一个时刻提供稳定、连续的任务进度判断。
有了这样的判断,RL Engine并不需要推翻原有的动作能力、重新学习一遍,而是在原有VLA能力之上,学习如何纠正偏差。
RL Engine采用继承基础模型KV值、轻量化Residual RL的方式,让RL Engine专门学习那些原有策略不擅长处理的纠错动作:当动作出现偏差时,应该如何调整;当环境发生变化时,应该如何重新对齐;当任务即将失败时,又应该如何把它拉回正确轨迹。
更进一步,HERON-CRA将真实世界与HERON-World Model结合起来:机器人在真实环境中不断产生成功与失败的经验,这些真实状态又可以作为起点,让HERON-World Model生成“想象轨迹”,帮助机器人在不增加真实硬件风险的情况下反复尝试和学习。
于是,一个持续运转的学习闭环被建立起来:机器人执行→获得结果→判断偏差→学习修正→再次执行。
从“做对一次”,到“能够持续修正”,RL Engine让机器人的行动能力开始具备持续进化的可能。
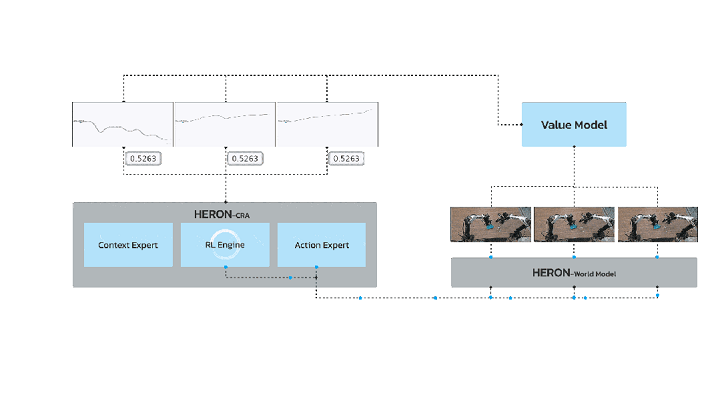
HERON-CRA和HERON-World Model互动
Cross-Embodiment Pretraining:让机器人学到的能力,跨越不同身体与任务
如果机器人只能在固定的身体和固定的任务中学习,那么即使它能够不断纠错,也很难真正走向通用。
现实世界中的机器人拥有不同的身体形态和动作能力,不同本体具有不同的运动方式、动作空间与操作边界;与此同时,它们面对的物体、环境和任务也各不相同。
这也是HERON-CRA在预训练阶段关注的问题:机器人究竟应该先学会什么?
HERON-CRA并没有把预训练的目标简单设定为学习如何控制某一台机器人,而是让模型首先从更加广泛、异构的数据中学习真实世界的规律——理解物体、空间、身体与环境之间如何发生交互。
为此,HERON-CRA融合了真实机器人遥操作、仿真数据、UMI以及第一视角人类视频等不同来源的数据,并覆盖人形机器人、轮式机器人、机械臂、夹爪、灵巧手等不同本体形态。
这些数据看似来自不同的机器人和不同的任务,但背后共享着一些更底层的规律:物体如何运动,空间如何变化,以及身体与环境之间如何发生交互。
因此,模型学习的并不只是“这台机器人应该怎样移动”,而是逐渐建立起对真实物理世界的理解。当面对新的机器人身体或新的任务时,它可以将已经形成的世界知识和任务经验迁移到新的场景中。
从“在一个身体上学会”,到“让能力跨越不同身体与任务”,Cross-Embodiment Pretraining让机器人真正开始走向通用。
结语
一周前,我们发布了HERON-World Model,让机器人学习世界,预演未来。
今天,HERON-CRA进一步让机器人记住过去,从错误中学习,将经验转化为能力。
HERON正在从“让机器人完成任务”,走向“让机器人持续获得能力”。
让智能,在真实世界生长。
注:文/龚作仁,文章来源:Laborer,本文为作者独立观点,不代表亿邦动力立场。
【版权提示】亿邦动力倡导尊重与保护知识产权。未经许可,任何人不得复制、转载、或以其他方式使用本网站的内容。如发现本站文章存在版权问题,烦请提供版权疑问、身份证明、版权证明、联系方式等发邮件至run@ebrun.com,我们将及时沟通与处理。
已点赞


{{ praise_text }}
好文章,值得被更多人看到
FAQ回顾
HERON-CRA是什么?
HERON-CRA是Scalabot于9月15日发布的HERON技术架构体系下的机器人行动模型,可帮助机器人建立任务记忆、从错误中学习修正、实现跨本体能力迁移,让机器人具备在真实世界中持续进化的自主行动能力。
真实场景下的通用操作机器人需要具备哪些核心能力?
真实场景环境多变,易出现物体位移、任务中断、动作偏差等问题,通用操作机器人除掌握基础动作执行能力外,还需具备长程任务记忆能力、动作偏差自我修正能力、跨机器人本体与跨任务的经验迁移能力,可在落地过程中持续进化。
HERON-CRA如何帮助机器人修正真实场景中的动作偏差?
HERON-CRA搭载的RL Engine模块通过Value Model提供连续的任务进度判断,采用轻量化Residual RL方式专门学习纠错动作,同时结合HERON-World Model生成模拟试错轨迹,形成执行-判断-修正的学习闭环,无需推翻原有动作能力重新学习。
下一篇

深耕充电安全、拓展家庭AIoT体系 绿联科技生态布局“两路并进”
日前,UGREEN绿联在厦门举办了主题为「惊喜联接·智护生活」的品牌全球发布会,公布了其在充电安全生态与AIoT生态产品方面的最新战略。









